微软 Outlook 故障的连锁反应:云办公时代的单点脆弱性
微软 Outlook 故障的连锁反应:云办公时代的单点脆弱性
当全球数百万知识工作者的邮箱与协作工具在同一时刻集体失联,微软 Outlook 故障不再只是一次服务中断,而是对“云即基础设施”假设的一次压力测试。
云计算的可靠性常被类比为电网:用户默认它永远在线,直到某一天整片区域突然断电。2026年11月12日美东时间中午前后,微软 Outlook 与 Exchange Online 的大规模故障,正是这种“默认在线”被打破的时刻。它让企业、政府与金融机构在工作日高峰期失去核心通信能力,并迅速演变为对云平台韧性与供应商集中度的公开讨论。真正值得追问的,不是故障本身有多长,而是下一次类似事件是否会更早到来、影响面是否会更大。
核心结论
- 单点依赖已成系统性风险:微软 365 覆盖超 4.3 亿用户与绝大多数财富 500 强企业,任何核心组件故障都会瞬间放大为全球生产力中断。
- 健康检查机制本身可能成为故障源:服务器因自动化健康检查失败而大规模离线,导致剩余基础设施过载,暴露了自我保护逻辑的双刃剑效应。
- 云办公时代的韧性需重新定价:企业不能再把“服务可用性”视为免费默认项,多供应商与本地冗余将成为新的成本与治理议题。
关键数据
- 约 13 万–14 万 — Downdetector 记录的 Outlook 问题报告峰值,出现在美东时间 11 月 12 日下午约 1 点前后。
- 74 个国家与地区 — 故障报告在约一小时内扩散至的地理范围。
- 超过 12 小时 — 从最初报告到仍未实现持续恢复的持续时长(截至 11 月 13 日凌晨美东时间)。
- 超 4.3 亿 — 微软 365 用户规模,其中绝大多数财富 500 强企业依赖其协作工具。
- 非网络攻击 — 微软高管明确排除恶意或网络活动导致故障的可能。
行动指南
🧑💻 技术从业者
立即梳理本团队对 Exchange Online 与 Teams 的硬依赖路径,优先落地离线缓存与备用通信通道(如企业即时通讯独立实例)。
在下次变更窗口前,主动验证健康检查与流量重定向逻辑是否可能形成正反馈过载。
🏢 企业决策者
要求 IT 团队在 30 天内提交“关键通信降级预案”,明确 Outlook 不可用时的业务优先级与替代工具切换时限。
把云服务商的历史重大事件频率与恢复时间写入年度供应商评估与合同 SLA 谈判条款。
📈 投资人与行业观察者
跟踪微软后续发布的 Post-Incident Report,重点关注根因是否指向配置、健康检查或容量管理,评估其对 365 续约与竞品切换意愿的影响。
把“云基础设施集中度风险”纳入对 SaaS 与办公软件赛道的长期估值折价模型。
目录
微软 Outlook 故障为何在健康检查环节触发连锁崩溃?
云办公市场的集中度是否已经过高?
企业与监管层会如何重新定价服务可用性?
常见问题解答
微软 Outlook 故障为何在健康检查环节触发连锁崩溃?
微软 Outlook 故障的直接触发点,并非外部流量激增,而是内部服务器因自动化健康检查失败而大规模退出服务。剩余基础设施被迫承担本应分散的负载,导致负责建立安全连接的进程过载,服务器停止处理请求。微软在事件初期确认,部分地区基础设施出现异常高负载,随后进一步指出问题与健康检查组件相关。
这种自我保护机制原本用于隔离故障节点,却在大规模并发失败时形成正反馈。服务器被标记为不可用后,流量进一步集中到存活节点,加速过载。微软尝试重启与替代健康检查方法后,部分服务器短暂恢复,但一旦重新接收流量,又可能再次失去响应。事件编号 EX1550543 与 MO1550821 分别覆盖 Exchange Online 与更广泛的 365 服务,显示影响已从邮箱扩展到 Teams 日历、Copilot 与部分管理中心页面。
技术上,这暴露了分布式系统中“健康检查本身不可靠”的经典风险。当检查逻辑或依赖组件出现系统性偏差时,保护机制会变成放大机制。微软排除了网络攻击可能,进一步将焦点锁定在内部配置与容量管理上。
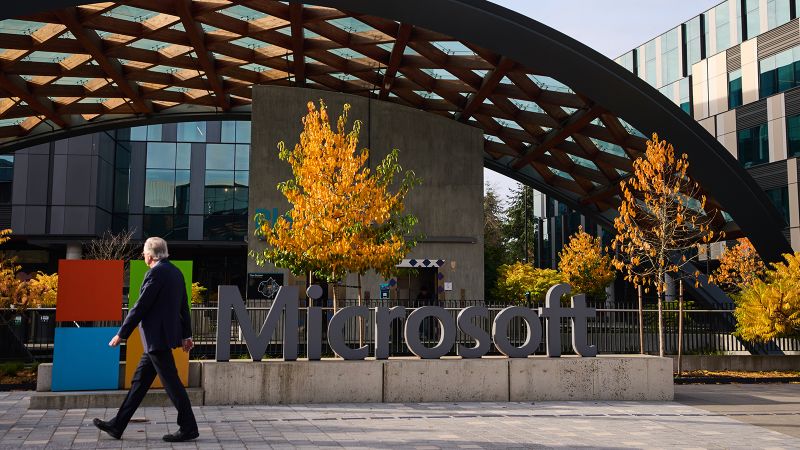
图注:微软雷德蒙德总部,故障期间全球用户高度关注其服务状态页更新。来源:AP / CNN
云办公市场的集中度是否已经过高?
微软 Outlook 故障发生在工作日中午高峰,影响迅速扩散至银行、政府机构、法院与航空公司。香港摩根士丹利与高盛员工、美国多地市政府、澳大利亚学校与日本政府系统均报告通信受阻。这种瞬时全球同步中断,正是高度集中的云办公格局的直接后果。
微软 365 已深度嵌入企业日常流程,邮箱、日历、文件与 AI 助手形成强耦合。一旦 Exchange Online 出现问题,依赖它的 Teams 日程、Copilot 数据访问与部分 SharePoint 功能同步降级。竞争对手虽存在,但迁移成本与数据惯性使多数企业短期内难以真正分散风险。事件因此成为对“单一供应商效率 vs. 多供应商韧性”的现实检验。
从市场角度看,集中度带来的效率红利正在被可用性风险重新定价。企业开始更认真评估混合部署与备用通信通道,监管与行业观察者则把注意力转向关键基础设施的供应商多样性。微软的故障并非孤例,但因其体量与渗透率,成为最清晰的警示信号。
企业与监管层会如何重新定价服务可用性?
微软 Outlook 故障持续超过 12 小时且恢复过程反复,迫使企业重新评估“服务永远在线”的隐含假设。许多组织在事件中发现,日常业务几乎无法在没有邮箱与即时协作工具的情况下运转,应急预案往往停留在纸面。
监管层面,事件发生在欧洲推动技术主权与减少对单一美国科技巨头依赖的背景之下。政府与关键基础设施运营方已开始审视对特定云服务的过度依赖。企业侧,合同中的 SLA、服务信用与事后报告要求预计会收紧;多云或本地冗余方案的预算讨论也将加速。微软高管 Charles Lamanna 公开表示:
我们遗憾今日的中断给客户造成了干扰,我们正在努力解决问题……目前可以确认,没有迹象表明这是恶意或网络活动的结果。
—— 来源:CNN / Microsoft EVP Charles Lamanna
这句话虽排除了安全事件,却无法消除对内部工程与运维韧性的质疑。长期看,服务可用性将从“默认承诺”变成可量化、可谈判、可 penalize 的商业条款。
常见问题解答
❓ 微软 Outlook 故障具体是什么?持续了多久?
2026 年 11 月 12 日美东时间中午前后,微软 Exchange Online 与 Outlook 出现大规模连接问题,用户无法正常访问邮箱、发送邮件,Teams 部分功能与 Copilot 也受影响。故障迅速从美洲扩散至全球约 74 个国家和地区,峰值时 Downdetector 记录约 13 万–14 万 Outlook 问题报告。截至 11 月 13 日凌晨,服务仍未实现持续全面恢复,持续时间超过 12 小时。
❓ 为什么这次故障影响如此广泛?是否网络攻击?
影响广泛的核心原因是微软 365 在企业办公中的极高渗透率,以及邮箱服务与其他协作、AI 功能的强耦合。微软高管明确排除恶意或网络活动,故障指向服务器健康检查失败导致的大规模节点离线与剩余基础设施过载。非攻击性质意味着问题更偏向工程与运维层面,而非外部威胁。
❓ 企业和个人现在可以做什么?未来趋势如何?
个人可先检查 status.cloud.microsoft 或官方状态账号确认全局问题,避免盲目重装客户端。企业应立即启用备用通信渠道,并评估对 Exchange Online 的硬依赖。长期看,云办公市场将更强调多供应商策略、本地冗余与更严格的 SLA,服务可用性会从隐性假设变为显性成本与治理议题。微软后续发布的事后报告将成为重要参考。
📅 本文信息综合自 X 实时热搜及权威科技媒体(如 CNN、Reuters、The Verge 等),更新至 2026 年 11 月 13 日凌晨美东时间,仅供参考。